KI-Personas als Hypothesen: Widersprüche sichtbar machen
Wie synthetische Personas Nutzungshypothesen und Testfragen liefern, ohne Interviews, Verhaltensdaten oder echte Nutzer zu ersetzen.
Kennst du „den perfekten Paul"? 28 Jahre, effizienzverliebt, trinkt nur fair gehandelten Kaffee und nutzt deine App jeden Tag genau so, wie du es dir gedacht hast. Das Problem: Paul gibt es nicht.
Eine Persona wie Paul kann in sich völlig schlüssig sein und trotzdem am wirklichen Nutzerverhalten vorbeigehen. Sprachmodelle verstärken dieses Risiko: Sie erzeugen schnell eine glatte Geschichte, auch wenn die Datengrundlage Lücken hat.
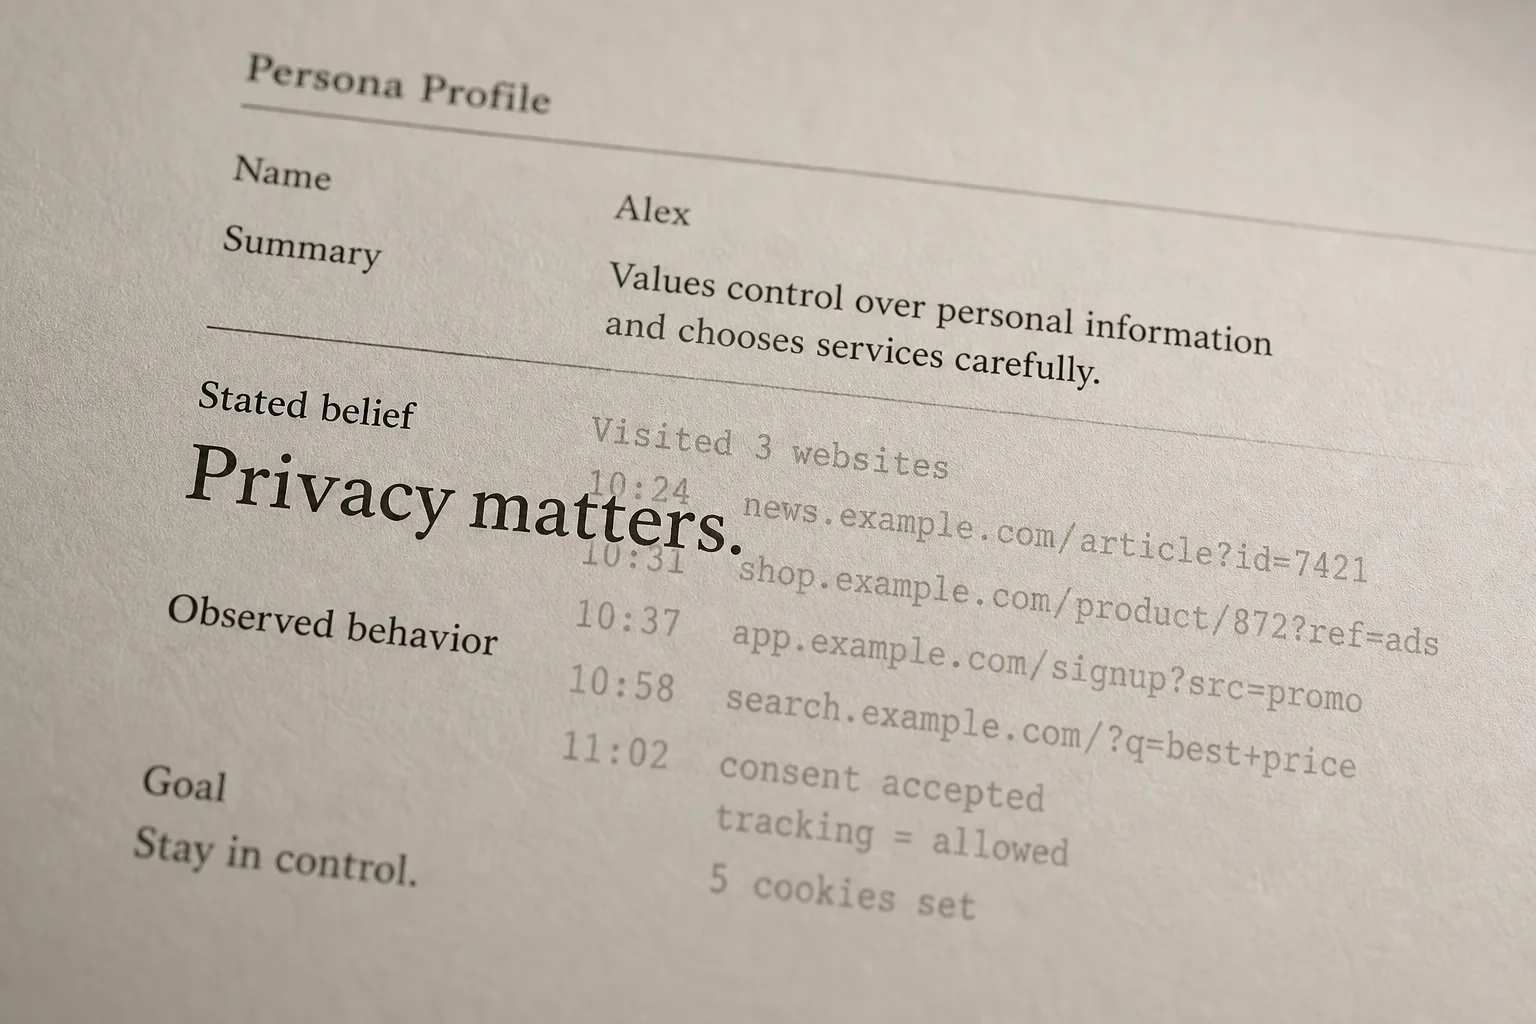
Der sinnvolle Einsatz beginnt deshalb nicht mit „Simuliere mir einen realistischen Nutzer“. Er beginnt mit einer engeren Frage: Welche plausiblen Erklärungen und offenen Fragen stecken in einer bereits beobachteten Spannung?
Eine synthetische Persona ist keine Nutzerforschung
LLMs können vorhandene Beobachtungen ordnen, Szenarien variieren und einen Workshop mit neuen Fragen versorgen. Ohne echte Nutzerdaten lassen sich damit Einstellungen, Segmentgrößen und Verhaltensverteilungen nicht messen.
Die Forschung stützt genau diese enge Rolle. In einer DIS-Studie zu Human-AI-Workflows für Personas funktionierte die Zusammenarbeit besser, wenn Menschen die Nutzerdaten zuerst nach relevanten Merkmalen gruppierten und das Modell daraus Entwürfe formulierte.1 SimUser ordnet simuliertes Feedback als heuristische Hilfe im Prototyping ein, nicht als Ersatz für Usability-Tests.2
Neuere Arbeiten mahnen zusätzlich zur Kalibrierung. Eine methodische Arbeit zu LLM-Simulationen trennt explorative Heuristiken von bestätigender Evidenz.3 In einem Preprint zu simulierten Präferenztests wichen synthetische Verteilungen in einem erheblichen Teil der untersuchten Aufgaben von menschlichen Ergebnissen ab.4 Daraus lässt sich keine allgemeine Fehlerquote für jede Persona ableiten. Es reicht aber als Warnung: Mehr Details, Namen und Widersprüche machen eine Ausgabe nicht automatisch realistischer.
Ein brauchbarer Ablauf
1. Beobachtungen vorbereiten
Als Grundlage nutzt du anonymisierte Interviewaussagen, Supportgründe, Suchanfragen, Analytics oder bereits veröffentlichte Forschung. Jede Beobachtung bekommt eine Quellen-ID. Personenbezogene oder sensible Rohdaten gehören nur in eine dafür freigegebene Umgebung.
Die Auswahl bleibt menschliche Arbeit. Das Team entscheidet, welche Unterschiede relevant sind und welche Datenlücken offenbleiben. Auch das GOV.UK Service Manual leitet Personas aus gelerntem Nutzerwissen ab und verlangt fortlaufende Prüfung mit echten oder wahrscheinlichen Nutzern.
2. Spannungen als Hypothesen formulieren
Statt dem Modell zwei „harte Widersprüche” vorzuschreiben, halte ich eine Beobachtung gegen mehrere Erklärungen. So entsteht keine vermeintliche Biografie, sondern eine Hypothesenkarte. Ein Prompt, den ich dafür nutze:
Du erhältst anonymisierte Beobachtungen mit Quellen-IDs.

Aufgabe:
1. Beschreibe die beobachtete Spannung, ohne neue Fakten zu ergänzen.
2. Formuliere zwei plausible Alternativerklärungen.
3. Nenne zu jeder Erklärung die stützenden Quellen-IDs.
4. Markiere Unsicherheit und fehlende Daten ausdrücklich.
5. Leite eine offene Forschungsfrage und eine passende Testaufgabe ab.

Regeln:
- Erfinde keine Zitate, Zahlen, Motive oder Erlebnisse.
- Schätze keine Segmentgrößen.
- Gib keine Designpriorität vor.

Beobachtungen:
- [QUELLE A]: [beobachtete Aussage oder Handlung]
- [QUELLE B]: [beobachteter Kontext oder Gegenbefund]
3. Die Ausgabe gegen die Quellen lesen
Für jede Zeile gilt dieselbe Frage: Steht das in den Daten, ist es eine klar markierte Deutung oder hat das Modell eine Lücke gefüllt? Erfundenes wird gestrichen. Auch scheinbar empathische direkte Rede gehört nicht in die Persona, wenn sie aus keinem Interview stammt.
So könnte eine Ausgabe aussehen, synthetisches Beispiel, kein Teilnehmerzitat: Lisa, 50, Lehrerin. Beobachtete Spannung: Sie sorgt sich um Datenklau, postet aber jeden Sonntag Fotos vom Enkel. Erklärung 1: Der soziale Anschlussdruck in der Familie wiegt schwerer als die abstrakte Datenschutz-Sorge. Erklärung 2: Die Sorge gilt eher fremden Dritten als dem engen Familienkreis. Offene Frage: Welche Erklärung trifft zu, und welche Funktion würde das Sicherheitsgefühl erhöhen, ohne den familiären Anschluss zu kosten?
4. Mit echten Nutzern entscheiden
Die synthetische Ausgabe darf einen Workshop, ein Szenario, einen Edge Case oder den nächsten Test vorbereiten. Priorisiert wird erst mit beobachtetem Verhalten, Nutzerfeedback oder belastbaren Bestandsdaten. Content Testing zeigt, wie aus einer Hypothese eine prüfbare Aufgabe und ein Entscheidungskriterium werden.
Synthetische Personas sind Hypothesengeneratoren. Sie ersetzen keine Interviews, Beobachtungen oder Usability-Tests und dürfen nicht wie Teilnehmerstimmen zitiert werden.
Hör auf, perfekte Nutzer zu suchen
Perfekte Nutzer gibt es nicht. Suche nach den Rissen und Brüchen, nach den kleinen Widersprüchen, über die echte Menschen stolpern. Aber Vorsicht: Wenn dich eine KI-Persona irritiert, ist das kein Gütesiegel für Realismus. Es ist ein Prüfimpuls, nicht mehr.
Eine irritierende Ausgabe kann eine übersehene Nutzungssituation sichtbar machen. Sie kann genauso gut ein Stereotyp oder ein Prompt-Artefakt sein. Erst die Rückbindung an Quellen und reale Nutzung zeigt, ob die Hypothese trägt.
Diese Grenze macht KI-Personas nicht wertlos. Sie macht ihren Wert genauer: Das Modell erweitert den Suchraum. Für Datengrundlage, Validierung und Entscheidung bleibst du verantwortlich.
Quellen & Referenzen