Verbalized Sampling: Mehr kreative KI-Antworten ohne Fine-Tuning
Ein Prompt für mehr Antwortvarianten, mit groben Modellwahrscheinlichkeiten, Kosten-Trade-off und einer klaren Auswahlregel.
Es gibt diese seltsame Paradoxie moderner Sprachmodelle: Sie sind beeindruckend klug, klingen aber trotzdem oft, als hätten sie sich auf eine einzige, „vernünftige“ Stimme geeinigt. Freundlich. Ausgewogen. Risikoarm. Und auf Dauer: vorhersehbar.
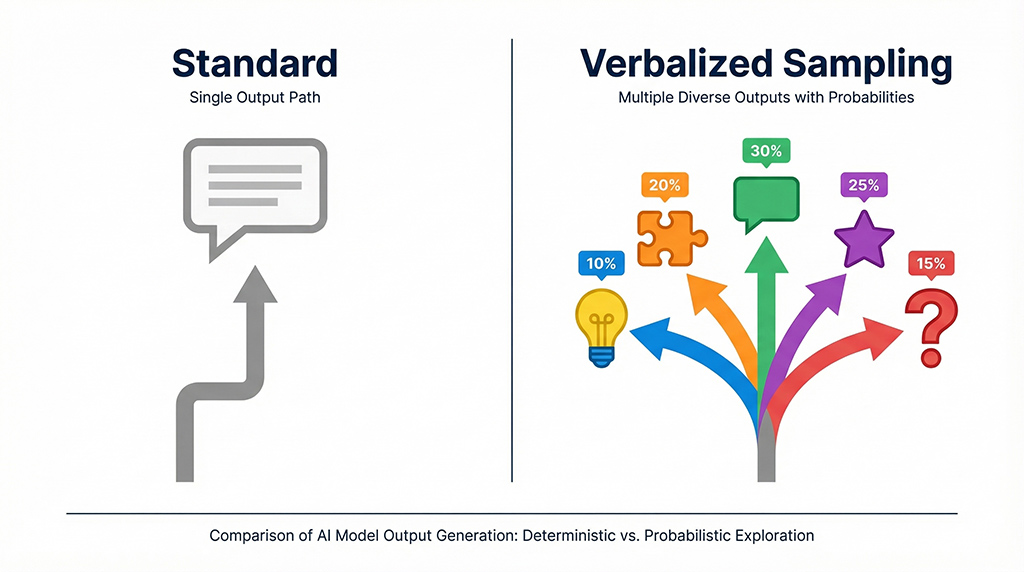
In der Forschung hat dieses Phänomen einen Namen: Mode Collapse. Das bedeutet nicht, dass ein Modell plötzlich unbrauchbar wird. Nach dem Alignment, etwa durch RLHF, kann ein Modell stärker in denselben Antwortmodus homogenisieren, besonders bei Aufgaben mit mehreren guten Antworten: kreatives Schreiben, Dialog, offene Fragen, Ideenfindung. Verbalized Sampling setzt genau dort an: Das Modell soll nicht sofort eine Antwort wählen, sondern mehrere Kandidaten samt einer groben, selbst geschätzten Verteilung ausgeben.
Das Verfahren stammt aus dem arXiv-Preprint Verbalized Sampling: How to Mitigate Mode Collapse and Unlock LLM Diversity. Die aktuelle Fassung v4 erschien am 15. Juli 2026.1 Im Kreativtest des Papers erhöhte die Methode die gemessene Vielfalt gegenüber direktem Prompting um das 1,6- bis 2,1-Fache. Das ist ein Befund für die dort getesteten Aufgaben und Modelle, kein allgemeiner Faktor für jede KI-Ausgabe.
Welches Problem die Methode adressiert
Das Paper untersucht eine Form von Antwort-Homogenisierung: Nach dem Post-Training können Modelle bei Aufgaben mit mehreren guten Lösungen häufiger in ähnlichen Antwortmustern landen. Als mögliche Erklärung prüft das Autorenteam einen Typicality Bias. Typische und vertraute Antworten könnten bei der Auswahl bevorzugt werden.
Das ist eine Hypothese mit experimentellen Indizien, kein Beweis dafür, dass Alignment jedes Modell oder jede Kultur auf dieselbe Weise glättet. Ein späterer Preprint findet ebenfalls starke Homogenisierung, aber deutliche Unterschiede zwischen Aufgaben und Modellfamilien.2
Wie Verbalized Sampling funktioniert
Beim direkten Prompting lautet die Aufgabe sinngemäß: „Gib mir die beste Antwort.” Verbalized Sampling verändert sie: „Zeige mehrere plausible Antworten und schätze ihre relative Wahrscheinlichkeit.” Damit kommen auch Varianten in die Ausgabe, die das Modell nicht an die erste Stelle gesetzt hätte.
Aus Workflow-Sicht fühlt sich VS an wie ein Hebel gegen den eingebauten „Be careful“-Reflex vieler Modelle. Du zwingst das System, mehr von dem zu zeigen, was es ohnehin weiß, aber normalerweise nicht als erste Wahl ausspielt.
Ein brauchbarer Grundprompt sieht so aus:
Erzeuge 5 unterschiedliche, plausible Antworten auf die Frage.
Gib zu jeder eine grobe, relative Wahrscheinlichkeit an; die Summe soll 1,0 ergeben.
Beziehe mindestens zwei ungewöhnliche, aber plausible Varianten ein.
Die Zahlen sind eine verbalisierte Heuristik, keine echten Token-Logprobs.
Markiere anschließend, welche Antwort für mein Ziel am besten passt und warum.

Frage: Welche ungewöhnliche Eröffnung eignet sich für einen Essay über digitale Müdigkeit?
Die Wahrscheinlichkeiten sind Selbstauskünfte des Modells. Laut Paper sind sie nicht perfekt kalibriert und funktionieren je nach Gegenstand unterschiedlich gut. Sie helfen beim Ordnen der Kandidaten, dürfen aber nicht wie gemessene Token-Wahrscheinlichkeiten behandelt werden.
Kandidaten sind noch kein Sampling
Im Chat liefert der Prompt zunächst ein Kandidaten-Set. Für einen vollständigen Sampling-Workflow kommen drei Schritte zusammen:
- mehrere Kandidaten erzeugen,
- eine verbalisierte Verteilung ausgeben,
- anschließend zufällig oder nach einer vorher festgelegten Regel auswählen.
Wenn ich einfach den passendsten Kandidaten markiere, nutze ich VS als Mehrperspektiven-Prompt. Soll tatsächlich entsprechend der Verteilung gezogen werden, braucht es eine Zufallsregel oder das offizielle Paket. Diese Trennung verhindert, dass eine hübsche Liste schon als reproduzierbares Sampling verkauft wird.
Für Sachfragen sollte die Auswahl außerdem nicht allein an einer unkalibrierten Zahl hängen. Quelle, Unsicherheit und fachliche Prüfung bleiben wichtiger als die vom Modell vergebene Wahrscheinlichkeit.
Was v4 zu Qualität und Aufwand berichtet
Im Paper blieb die Qualität der getesteten Kreativaufgaben in der menschlichen Bewertung ungefähr vergleichbar, aber nicht durchgehend besser. Auch die Safety-Werte änderten sich im untersuchten StrongReject-Set nur geringfügig. Beides ist keine Garantie für andere Modelle, Aufgaben oder Sicherheitstests.
Das Paper berichtet außerdem einen Trend: leistungsfähigere Modelle profitierten in den Tests stärker von VS. Das passt zur Intuition: Je größer der interne Möglichkeitsraum, desto mehr lohnt es sich, ihn überhaupt abzurufen.
Der frühere Claim von zwei- bis fünffachem Token-Overhead war zu hoch. In der paperinternen Kostentabelle lag VS-Standard bei etwa 1,12-fachen Kosten und 1,23-facher Laufzeit gegenüber der direkten Baseline. Varianten mit zusätzlichem Reasoning oder mehreren Durchläufen waren teurer. Diese Werte stammen aus der Messkonfiguration des Papers und sind keine feste API-Kalkulation.
Wo die Methode an Grenzen stößt
VS ist kein Zauberstab, sondern ein Inference-Time-Kompromiss:
- Mehr Kandidaten kosten zusätzliche Tokens und Prüfzeit.
- Verbalisierte Wahrscheinlichkeiten können schlecht kalibriert sein: Die Zahlen sind manchmal eher „kalibriertes Storytelling“ als echte Modellwahrscheinlichkeit.
- Mehr Vielfalt kann auch unpassende oder übermäßig gestreute Antworten erzeugen.
- Schema- oder Formatkonformität ersetzt keine inhaltliche Prüfung.
- Safety muss für das eingesetzte Modell und den konkreten Anwendungsfall getestet werden.
Eine spätere Untersuchung zur Population-Simulation zeigt den Trade-off besonders klar: VS erhöhte dort die Streuung, konnte aber von Unter- zu Überdispersion kippen.3 Mehr Vielfalt ist also kein Selbstzweck. Sie muss zur Aufgabe passen.
Wann ich VS einsetzen würde
Gut passt die Methode zu Ideenfindung, offenen Erklärungen, Dialogvarianten und Aufgaben, bei denen die erste plausible Antwort nicht automatisch die interessanteste ist. Für eine eindeutige Faktenabfrage, eine kleine Formatänderung oder einen streng geprüften Produktionsschritt ist der zusätzliche Kandidatenraum oft unnötig.
Auch klassische Sampling-Parameter wie Temperature oder Top-p bleiben Optionen. Sie greifen an einem anderen Kontrollpunkt: Der Anbieter verändert die technische Token-Auswahl, während VS den Kandidatenraum über den Prompt sichtbar macht. Das Paper kombiniert beide Ansätze ebenfalls; sie sind keine pauschal austauschbaren Rezepte.
VS ist besonders dann stark, wenn du spürst: „Das Modell kann mehr – es zeigt es nur nicht.“
Für strukturierte, maschinenlesbare Ergebnisse ist der Beitrag zu Taxonomie, JSON Schema und Structured Outputs die passendere Fortsetzung. Wie Prompt-Iteration in einem laufenden System aussieht, zeigt mein wöchentlicher KI-Briefing-Agent.
Quellen & Referenzen
Material zur Methode: Projektseite sowie Code und Reproduktionsmaterial des CHATS Lab. Beides ist Begleitmaterial der Autoren, kein unabhängiger Beleg.